剪贴板历史是碎片化、没有组织的一段段记录。大多时候,Win+V 只给你最近的一条;而第三方剪贴板管理器,大多给一条按时间倒序的列表,外加一个只能匹配前缀的搜索框。条数少的时候,这些已经够用了。而 Syzygy 免费版保留最近 100 条、最长 30 天;当列表不断累积,达到成百上千条记录时,"复制过"和"找得回"就成了两件事。
上周的报错栈、三个工作日前的工单号、某张聊天截图里的一段话,这些都是曾经复制过的,怎么会找不到呢!?这三个场景对应三种检索失败:纯数字串被词法搜索切碎、术语换了措辞就匹配不上、图片无法通过文本找回。
Syzygy 的做法是把检索看作一个很重要的基础设施,将其当作一个核心的本地引擎来进行构筑:一个覆盖最近 5000 条记录的 tantivy 索引、一条把词法与向量排名合成起来的混合检索路径、一套把查询写具体的限定符语法,再配上把截图和 PDF 变成可搜文本的本地 OCR。本文会一一讲解这四个部分是如何构建的,以及说明这些部分之间的合理交互和协同增强,当然,还有各自"辖区"内的事物。
文字是最容易实现搜索索引的:基础的本地索引
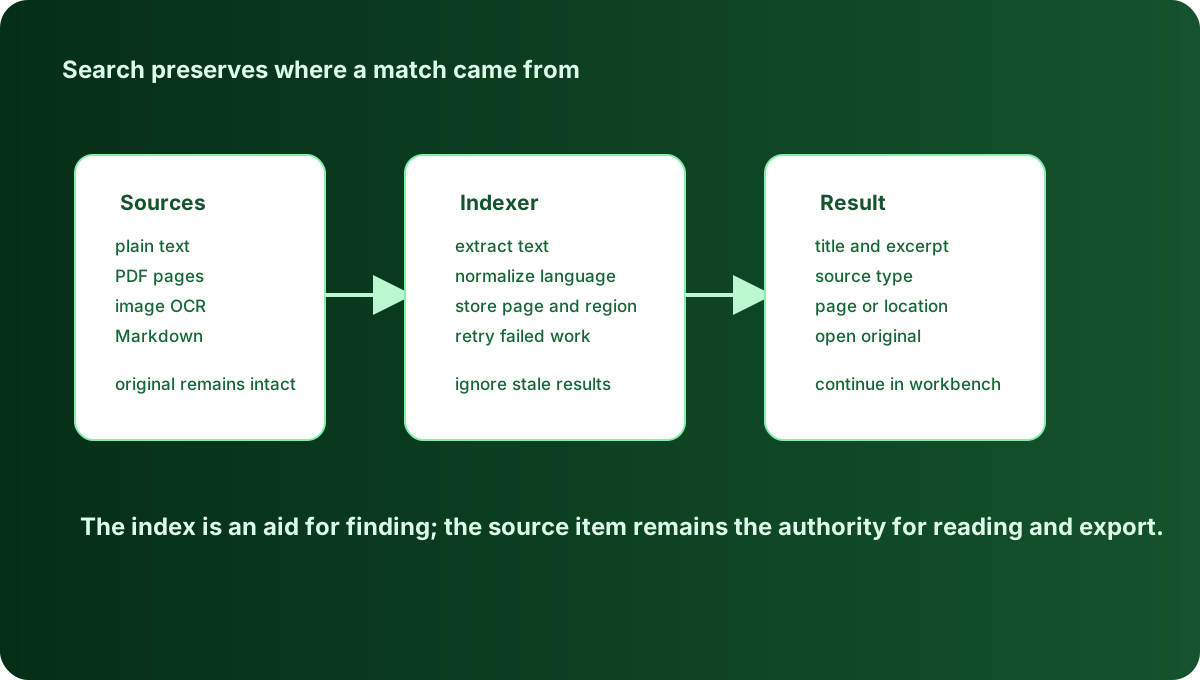
剪贴板内容的原始形态五花八门:纯文本、HTML、图片、文件。直接拿原始字节做检索没有意义,Syzygy 在入库时做一次文本处理,将其中可读、有效的信息提取出来,把每种格式都转成可索引的文字。纯文本直接解码(UTF-8 与 UTF-16 都处理);HTML 先剥掉标签留下正文;PDF 走文本层抽取;图片和没有文本层的 PDF 页面交给本地 OCR,识别到的文本内容等等则被收编进入索引。
索引器常驻后台,跟着剪贴板采集的节奏增量工作(采集轮询间隔是 150 毫秒,复制内容几乎无感入库),滚动覆盖最近的最多 5000 条记录,单条正文的索引预算(能够被识别和处理的最大字节数)是 512KB。这两个配置,划定好了索引的能力范围,定好了边界:5000 条对高频剪贴板用户大约是几周到几个月的滚动窗口,512KB 意味着一整篇长文档、一整段代码文件都能完整进入索引,而一条 20MB 的日志更适合按需打开而不是常驻索引。
除了正文,每条记录的元数据(即描述这条记录属性的信息,比如它从哪来、是什么类型、什么时候产生的)也一起进了索引:来源应用、标签、所属设备(peer)、内容类型、创建时间。它们既是后面限定符查询的数据基础,也让"哪台设备复制、从哪个应用复制"成为可查询的维度。
多文件条目有明确的策略:文件名本身直接进索引,符合白名单的文件类型(默认覆盖 md、txt、json、log、pdf 与常见代码、图片格式)再按内容索引;图片内容等模型就绪后再补充识别文本,不阻塞其余部分。
整个索引在本地磁盘上。配置里的 allow_remote 默认是关闭的:它控制的是语义索引的向量 embedding 是否允许调用远程服务;关闭时,embedding 计算与查询全部在本机完成,正文内容不会发往任何服务器。跨设备这一维同样如此:配对设备之间同步的是记录本身,搜索始终发生在本机,索引不会发去远端执行。
flowchart LR
  A[剪贴板条目] --> B["采集入库<br/>150ms 轮询"]
  B --> C["本地索引<br/>正文 + 元数据<br/>最多 5000 条 / 单条 512KB"]
  C --> D[词法查询]
  C --> E[向量检索]
  D --> F["RRF 排名合成"]
  E --> F
  C --> G["限定符过滤<br/>kind / tag / peer / date"]
G --> F词法怎么查:多词、精确与短语加权
Syzygy 对普通的多词查询采用"必须全部命中"的布尔策略:查 paddle ocr 配置,三条词目都得在文档里出现,数量对不上直接淘汰,避免一堆只沾边的半命中。
在硬性过滤之上叠了两层加权:整词精确命中权重乘 2.0,按原始顺序构成短语的再乘 4.0。也就是说,搜 recall memory 时,同时含这两个词的都算命中,含 "recall memory" 这个完整短语的排得更靠前。如果你做支持工作、一天复制几十个工单号,这类串走精确命中加短语加权,比任何模糊匹配都直接。
有两类内容被特殊对待:纯数字串和 8 位以上的十六进制串只走精确匹配。工单号 88231 不会被分词拆散,API key a3f9c2d1... 不会被模糊变形,而这样的结果正是我们所希望的。
一旦你在查询里写出显式语法(AND、OR、NOT、双引号短语、取反的减号、括号分组或任何字段限定符),Syzygy 就把查询完整交给 tantivy 的原生解析器,不再套上面的混合策略。想要使用高级布尔逻辑进行更加细致的搜索的话,我们软件也是支持的;同时,不懂、或者不想学习这些语法的用户,使用默认策略也已经足够。
只靠词法或只靠向量检索,都会漏掉一部分结果:RRF 的排名合成
你记得"那个报错",记录里写的却是"error occurred";你记得"会议纪要",当时的标签却是"meeting notes"。大多数时候,用词就是这样对不上,只靠词法索引的系统这时就找不出来了。
反过来,工单号、API key、十六进制哈希这类精确标识符,只靠向量检索的系统也招架不住:embedding 会把它们揉进语义空间里,和相近的数字串混在一起;而词法检索对这类内容是一查一个准。两条路各有胜场,丢掉任何一条都在赌博。
Syzygy 两条都用,然后用 Reciprocal Rank Fusion(RRF)把两份排名合成一份。机制本身很朴素:每张榜单给每个命中的文档记 1/(k + rank) 分,k 取 60,两榜相加后重排。排第一的文档从一张榜拿 1/61 ≈ 0.0164,从另一张榜也拿 1/61,合计 0.0328;一个在两榜都排第 10 的文档拿 2/70 ≈ 0.0286,稳稳压过只在一张榜排第 3 的 1/63 ≈ 0.0159。
为什么合成排名而不是合成分数?因为 BM25 分数和余弦相似度根本不在一个量纲上,直接相加需要人为标定权重。排名没有量纲,RRF 只看名次,两路检索不需要任何相互校准,这也是它成为检索系统标配的原因。k=60 的作用是压平单榜头名的权重,让"两边都认可"的文档浮上来。
这个合成还有两个实用的退化行为:某一边检索不可用(比如本地 embedding 模型还没下载好)时,结果就是另一边的原序,功能不失效;元数据 token 永远不进 embedding,向量只对正文投影计算,索引的哪一半命中了你的查询,系统里是清楚的。
隐私边界也嵌在合成层:只靠语义召回、且内容命中敏感信息打码规则的条目,不会进入结果。词法命中意味着文本本来就能整段看到,语义召回则可能把打了码的内容"猜"出来,这条路被显式掐断。
如果你是研究者,一个月前抄过一段文献原句,只记得大意和两三个关键词,词法负责把关键词对上,向量负责把大意对上,两边都命中的那条会排到最前面。
限定符:把"大概记得"写成具体条件
纯文本查询是概率游戏,限定符把它变成条件查询。Syzygy 的搜索框支持六个核心限定符,每个都带别名和取反语法:
kind:按内容类型,取值 text、html、image、files,另有 link 和 color 两个从文本派生的虚拟类型(type:是别名,-kind:image排除图片)tag:按标签过滤,多个 tag 之间是"同时具有"的与关系is:按状态,取值 pinned、favorited、pending、local、remotesource:按来源应用,app:是别名peer:按来源设备,origin:、device:是别名date:按创建时间,支持 today、yesterday、7d、30d,也支持具体日期和区间写法(>=2026-09-01、2026-09-01..2026-09-07)
日期在索引侧同时以年、年月、具体日三种粒度生成 token,所以 date:2026-09 这类粗粒度条件也是一次命中,不用展开成 30 个日期。
输入时搜索框会提供建议:限定符键、每个键的合法取值、以及从你真实数据里拉出来的候选池。tag: 会列出你实际用过的标签,source: 会列出实际复制过内容的应用,值带空格时自动加引号。不需要背语法,打到一半看着选就行。
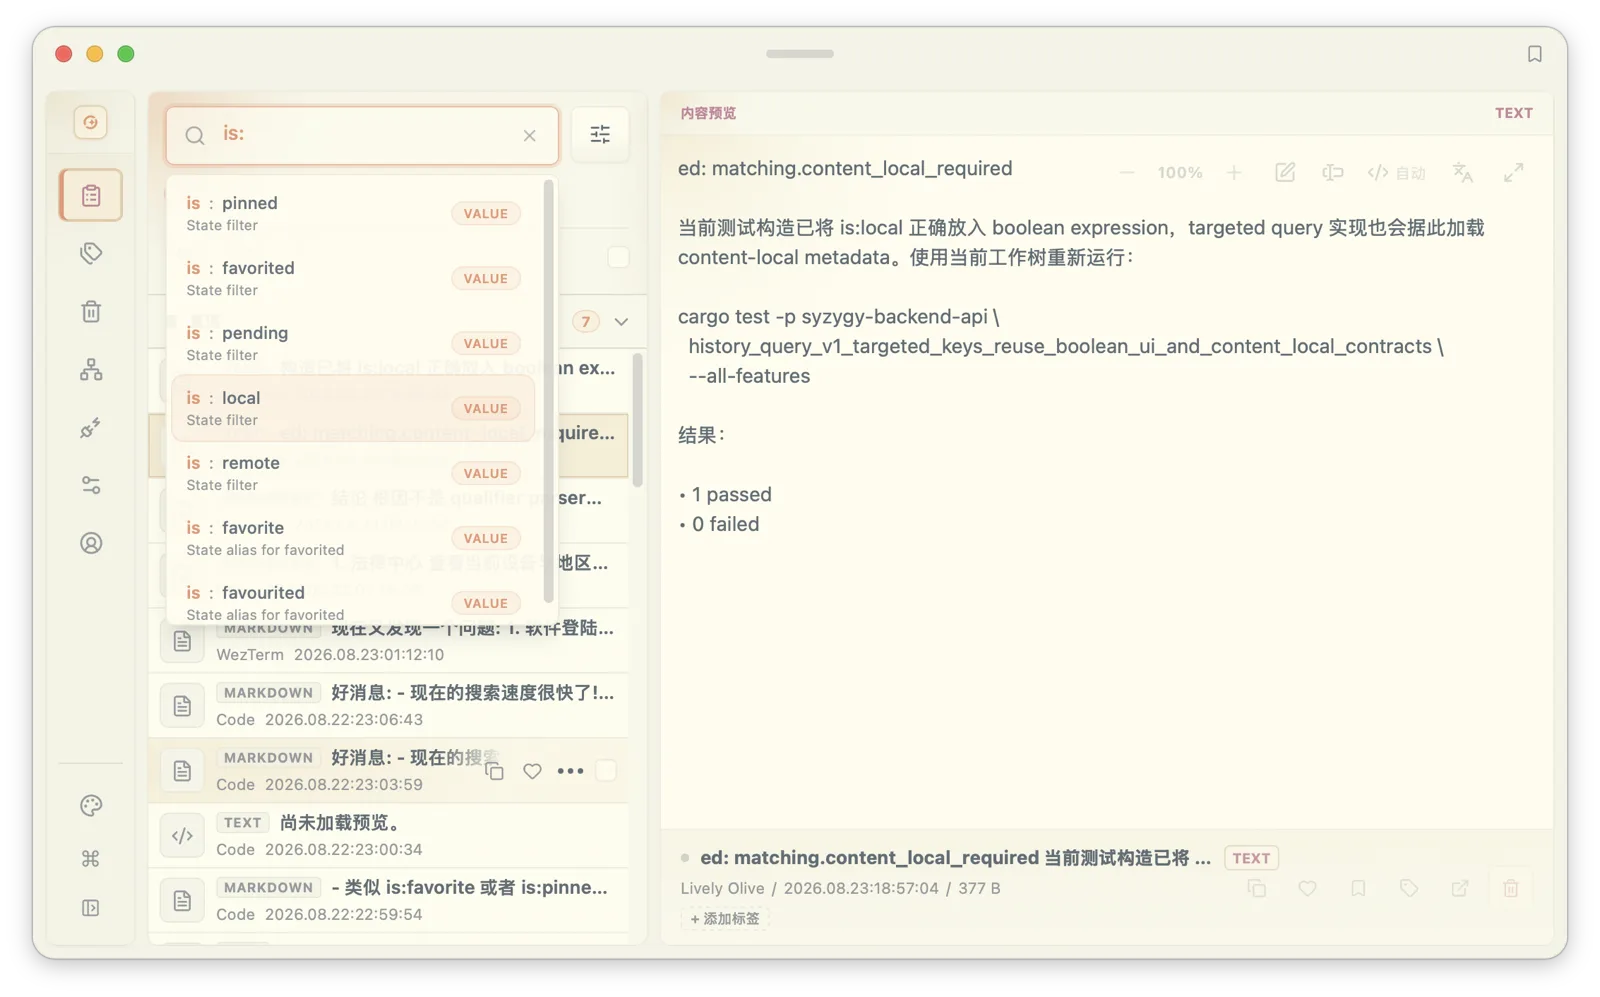
组合起来,查询可以写得很具体:source:chrome date:7d kind:text error,意思是"最近一周从 Chrome 复制的、提到 error 的文本"。如果你是程序员,排查问题时把范围缩到 IDE 和终端,比在一整条时间线里滚动快得多;如果你是运营,tag:文案 is:pinned 直接圈出置顶过的素材。
找到之后还有粘贴这一步。macOS 上 Option+Shift+V 唤出快捷面板,方向键选择,Shift+右进入全界面预览;预览里 Cmd/Ctrl+O 直接对图片内容跑 OCR,Cmd/Ctrl+T 翻译,Cmd/Ctrl+E 进入编辑。置顶过的条目可以用 Ctrl+Option 加数字键 0 到 9 直接粘贴对应顺位,常用回复模板这类高频内容不需要打开主窗口。
隐私这条线:先识别,再决定
搜索能力变强之后,"能查到"和"该不该看到"必须一起设计。Syzygy 默认开启敏感内容识别,内置 12 类规则:身份证号、手机号、验证码、邮箱、银行卡号(带 Luhn 校验位验证)、API 密钥、激活码,以及 EVM 地址、比特币地址、EVM 私钥、比特币私钥、BIP39 助记词五类 Web3 内容。规则之外还支持自定义正则,以及按来源应用配置拒绝采集名单,密码管理器里的内容可以从源头就不进历史。
命中规则之后的行为分两个独立开关:敏感内容打码默认开启,涉及同步的阻断默认关闭。也就是说默认行为是"你自己能看到但内容被遮蔽处理",要不要阻止它同步到其他设备,由你根据威胁模型自己决定。前面提到的语义召回排除,就是这套识别与搜索管线的衔接点之一。
把这条线写进搜索文章,是因为它们本来就是一体的:检索让三年前的剪贴板内容一秒可查,也让三年前复制过的密码一秒可查。识别规则先于检索存在,才是安全的顺序。
截图里的字:OCR 管线的三个取舍
图片进索引的前提是它有文字,所以 OCR 是搜索管线的一部分,而不只是预览时的按钮。这条管线有三个取舍。
第一个是分辨率。Syzygy 送入识别引擎前把图片最长边缩到 1600 像素(可在 256 到 4096 之间调整)。手机截图通常正好在这个尺寸附近,桌面截图普遍更宽。缩放太小会丢掉小字号,不缩则大图识别又慢又费内存。1600 是识别质量与开销的折中点,对四五千像素宽的桌面截图,缩到 1600 后正文文字仍然清晰可辨。识别框的坐标会按缩放比例投回原图,所以你在预览里看到的每个识别块,位置都对应原始截图。
第二个是引擎链。默认链条是 mixed:先走本地 Paddle OCR 模型(检测、识别、字符集三件套来自带校验和的公开模型目录,首次使用自动就位),失败再落到系统引擎(macOS 与 Windows 各自的系统能力)。你也可以锁定只用本地模型、只用系统引擎,或者接一个 tesseract 命令行。引擎默认不出网,自动索引里更是一条通往远端视觉服务的请求都不会发;只有你手动对某条图片内容发起视觉识别时,才可能用到你自己配置的账号。
第三个是缓存。识别结果按内容哈希缓存,缓存键里还带着引擎链、语言提示、max_px 和用途。同一张截图第二次遇到时直接读缓存,不重复识别;你调整了 max_px 或换了引擎,缓存键随之改变,也不会读到旧结果。用途分两类也要说一句:预览里点 OCR 按钮拿带坐标的结果(方便按行回贴),进索引的识别走独立的召回用途,两者互不污染缓存。
还有一个容易被忽略的状态区分:识别出"空文本"和识别"失败"在系统里是两回事。一张确实没有文字的图,识别完成、结果为空,这是一次正常观察;模型没就绪、引擎崩溃则是失败,不会被当成"已识别但没字"记进索引。这个区分决定了重试与缓存的行为,也让搜索结果里的"图片没有文字"这个判断本身可信。
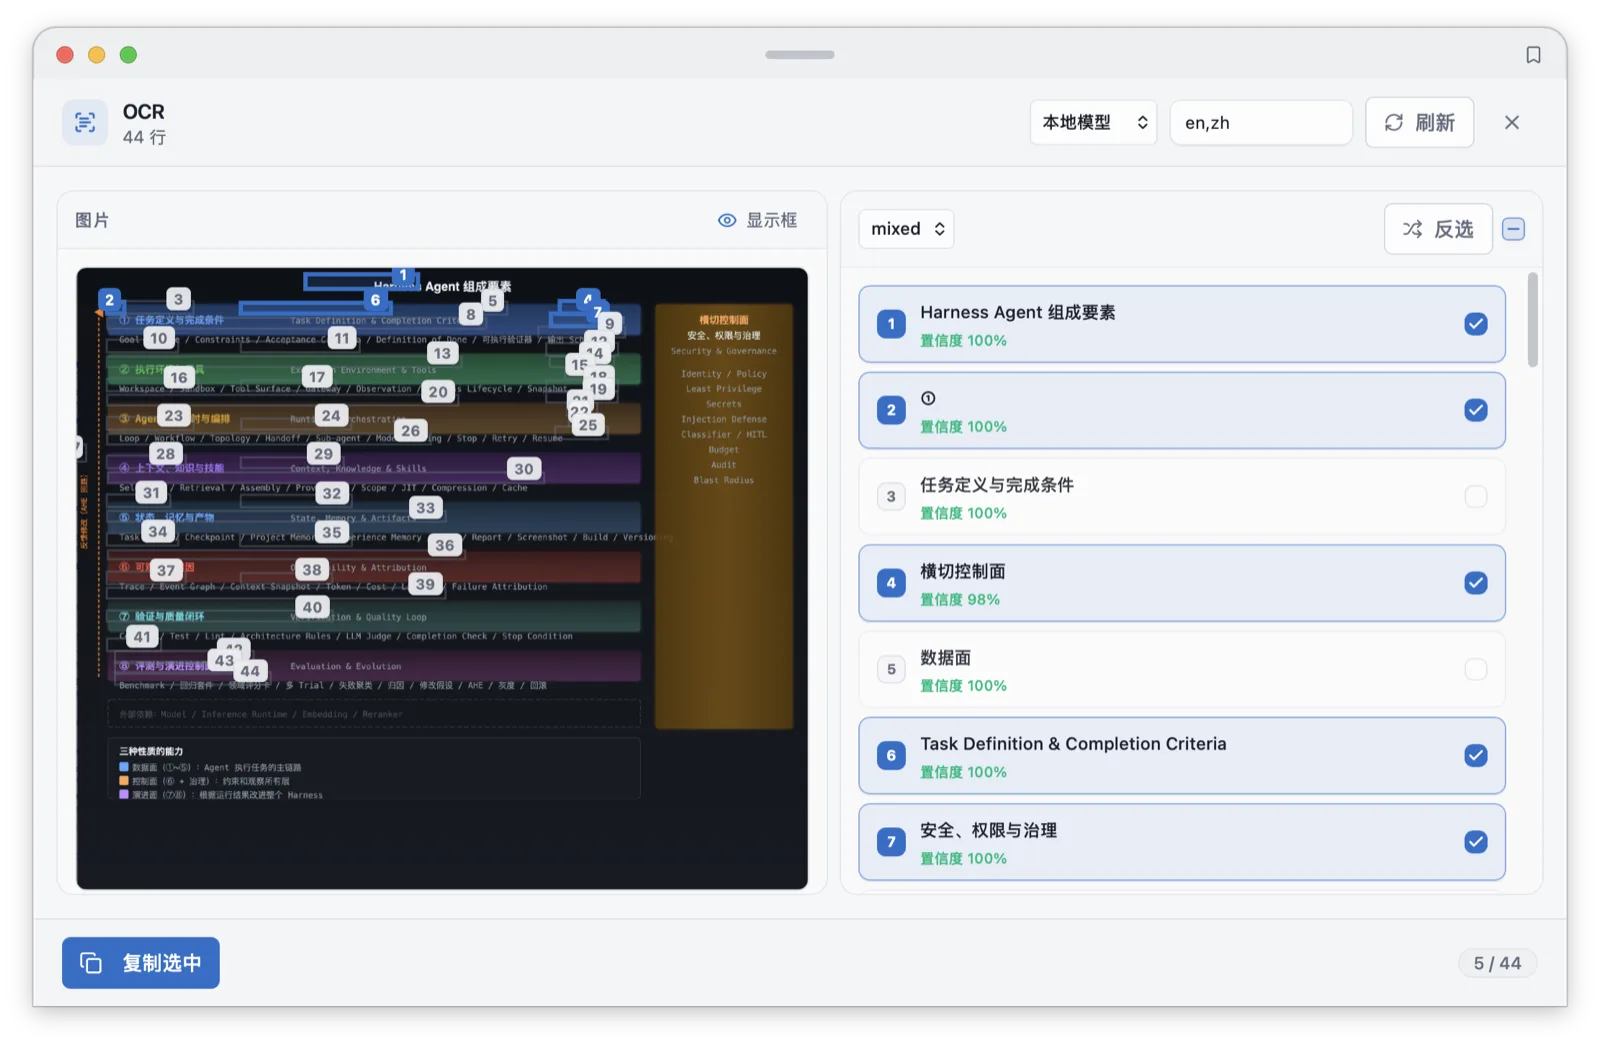
如果你是学生或研究人员,拍书页、拍讲义、拍白板,存进剪贴板的截图从此都是可搜文本;半年后搜一个记得的术语,当时那张白板照片会自己出来。
PDF:64 页预算与双层抽取
复制一个 PDF 文件到剪贴板,Syzygy 对它的处理分两层。第一层抽文本层:能直接抽出来的文字最快、最准,逐页进行,上限 64 页。第二层处理空页:那些本质上是扫描件的页面没有文本层,Syzygy 把它们渲染成图片(用上面说的 max_px 缩放),再走一遍 OCR,把识别结果填回对应页。
两层处理各自记录来源:一段检索命中的 PDF 内容,到底来自原文文本层还是 OCR 识别,系统里有记录。预算耗尽时也会如实标注:读了多少页、总共多少页、是否被预算截断,这些覆盖信息随结果一起返回,不存在"看起来读完了其实没有"的状态。整份 PDF 的处理结果按内容哈希加页数预算缓存,同一份文件不会重复走第二遍 OCR。
64 页这个上限覆盖了绝大多数论文、合同和技术手册;更大的书更适合用专门的阅读器管理。配合 32MB 的本地读取上限,索引器不会因为一条巨型复制内容卡住。如果你是法务或采购,合同 PDF 复制进来,之后凭条款关键词直接搜到是第几页的内容。
复制过的,都该找得回来
四层各管一段:文本投影决定什么可索引,5000 条与 512KB 划定窗口,RRF 决定排名怎么合成,限定符和 OCR 负责把模糊的记忆变成精确的查询条件。它们全部跑在你自己的电脑上,这是设计起点,不是事后补偿。
刚装好的话,建议按这个顺序走一遍:登录后在设置里打开 macOS 辅助功能权限,正常复制半小时让索引积累数据,然后在搜索框输入 kind:image 挑一张截图试试 OCR 回填,最后玩一下 date:today source: 加你的常用浏览器。安装与初始化的完整步骤在安装与首次运行指南;想先弄清楚每种内容类型会被如何处理,看剪贴板内容类型图鉴;索引建好之后怎么用标签和回收站组织内容,见标签、回收站与剪贴板整理。
搜索这件事,剪贴板工具做得越久越像一个小型搜索引擎。语义这一半依赖的本地 embedding 模型,与 1.2.0 引入的本地大模型共用同一套本地推理底座,后续演进写在本地模型工作台里。Syzygy 选的路线是先把本地的部分做扎实,联网能力全部留成显式开关。
常见问题
剪贴板历史里的截图也能被搜到吗?
可以。Syzygy 对图片执行本地 OCR,识别出的文字与图片本身一起进入搜索索引。你在搜索框里输入截图里的关键词,或者用 kind:image 限定符把范围缩到图片,都能找回它。识别默认走本地模型,不联网。
搜索索引覆盖多少条剪贴板记录?
索引最多覆盖最近的 5000 条剪贴板记录,单条正文最多索引 512KB。免费版历史本身保留 100 条、最长 30 天,配对设备的记录也会进入这台设备的索引;实际索引量取决于本地保留下来的内容量。
语义检索需要联网或付费吗?
不需要联网。语义这一半由本地 embedding 模型承担,索引和查询都在你的电脑上完成。Syzygy 也支持在设置里显式授权远程 embedding,但那是可选项,默认关闭。
包含手机号、银行卡号的内容会被搜出来同步出去吗?
Syzygy 默认开启敏感内容识别,覆盖身份证号、手机号、验证码、邮箱、银行卡号、API 密钥等 12 类规则。命中打码规则的内容在纯语义召回下不会进入搜索结果,是否同步到其他设备另有独立开关控制。